Data engineering & ETL-pipelines
Byg pålidelige pipelines, der flytter og transformerer dine data sikkert.
Book møde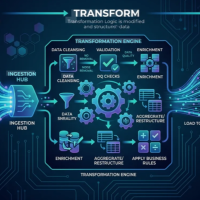
Hvorfor det er vigtigt
Analyse og AI er kun så gode som de data, der fodrer dem. Uden pålidelige pipelines er data spredt, inkonsistent og forsinket — og hver rapport kræver manuelt arbejde.
Vi bygger ETL- og ELT-pipelines, der flytter, renser og transformerer data pålideligt og automatisk. Pipelinene er observerbare, testede og genopretter fra fejl, uden at nogen vågner midt om natten.
Pålidelige data er forudsætningen for alt andet: uden dem hviler analyse, prognoser og AI på sand. Vi bygger pipelines, der holder, genopretter fra fejl og alarmerer i tide.
Sådan griber vi det an
Vi kortlægger kildesystemer, bygger orkestrerede ETL/ELT-pipelines og tilføjer automatiske kvalitetstest. Vi dokumenterer alt, så dit team selv kan vedligeholde løsningen.
Sådan arbejder vi
En klar proces fra idé til produktion.
Kortlægning
Vi forstår dine mål, nuværende tilstand og data.
Design
Vi definerer løsningens arkitektur og omfang.
Prototype
Vi bygger en hurtig version, du kan se og evaluere.
Byg
Vi tager løsningen til produktion iterativt og transparent.
Validering
Vi tester, måler og bekræfter pålidelighed.
Optimering
Vi finjusterer, dokumenterer og skalerer.
Anvendelsestilfælde
Kildeintegration
Forén databaser, API'er og filer til ét flow.
Datarensning
Standardisér, dedupliker og validér automatisk.
Inkrementel indlæsning
Behandl kun ændrede data effektivt.
Orkestrering
Planlæg og kæd jobs med deres afhængigheder.
Datakvalitetstest
Forhindr forkerte data i at nå rapporter.
Migrering
Flyt data til en ny platform på en kontrolleret måde.
Hvad der er inkluderet
- Kortlægning af kildesystemer
- Opbygning af ETL/ELT-pipelines
- Automatiske kvalitetstest
- Orkestrering og alarmering
- Dokumentation og overdragelse
Hvad du opnår
Pålidelige, opdaterede data
Færre brydende processer
Skalerbarhed med vækst
Teknologier & kompetencer
Ofte stillede spørgsmål
Ja. Vi bygger pipelines i det miljø, du vælger, hvad enten det er sky, hybrid eller eget datacenter.
Pipelinene har advarsler og automatisk genopretning; kritiske fejl rapporteres til den kanal, du vælger.
Ja. Vi tilpasser løsningen til din eksisterende stack i stedet for at tvinge en total udskiftning igennem.
Vi bygger automatiske kvalitetstest, der standser forkerte data, før de spredes.
Relaterede tjenester
Datawarehouse & data lake-implementering
Centralisér dine data i en skalerbar, forespørgselsklar arkitektur.
Læs mere →
Generativ AI & LLM-integration
Integrér sprogmodeller i dine produkter og arbejdsgange, sikkert.
Læs mere →
AI-drevet procesautomatisering
Automatisér gentagne arbejdsgange og frigør dine teams til mere værdifuldt arbejde.
Læs mere →Klar til at komme i gang?
Book et gratis kortlægningsmøde — lad os tale om, hvordan data og AI kan hjælpe netop dig.
Book møde